우리는 흔히 null pointer를 인자로 넘길 때 0을 쓰곤 한다. C++은 포인터가 사용돼야 하는 상황에서 0을 본다면 마지못해 null pointer로 그것을 해석한다. 하지만 엄밀히 0은 int이다.


NULL도 마찬가지이다. NULL의 구현은 때에 따라 다르지만, 보통 int나 long으로 구현되어 있다.


아무튼 이로 인해 C++98에서는 pointer와 integral type의 function overloading을 피하곤 했다. 이는 C++11에서도 유효한데, 왜냐하면 아직도 많은 개발자들이  0과 NULL을 null pointer을 나타내기 위해 쓰기 때문이다(nullptr이 더 좋은 선택임에도 불구하고!).


예시를 보자.

void f(int); // three overloads of f
void f(bool);
void f(void*);

f(0); // calls f(int), not f(void*)
f(NULL); // might not compile, but typically calls f(int).
	     // Never calls f(void*)

integral type과 pointer overloaded function에서는 f(0)과 f(NULL)은 f(void*)를 부를 수 없다!


nullptr을 쓰는 것의 이점은, 그것이 integral type이 아니란 것이다. 사실 pointer type도 아니다. nullptr은 std::nullptr_t의 타입을 갖고 있다. std::nullptr_t는 implicit 하게 모든 raw pointer type으로 변환된다.


위의 예시에서 f(nullptr)은 f(void*)를 부른다!


또 다른 장점은, 코드의 가독성을 높여준다는 것이다. 특히, auto가 사용된 다음 예시를 보자.

auto result = findRecord( /* arguments */ );
if (result == 0) {
 …
}

위의 코드만 봐서는 findRecord 함수가 return하는 것이 integral type인지 pointer type인지 알 수 없다.

하지만,

auto result = findRecord( /* arguments */ );
if (result == nullptr) {
 …
}

이렇게 짠다면, findRecord가 return하는 값은 pointer type이란 것을 명확히 알 수 있다.


nullptr의 이점은 template을 쓸 때도 나타난다. 우선 다음 예시를 보자.

int f(std::shared_ptr<int> spw);

auto result = f(0);

위 코드는 문제없이 컴파일된다. f는 포인터 타입을 인자로 받는 함수인데, 0이 들어왔으므로 '마지못해' null ptr로 해석하게 된다. 하지만 템플릿을 사용하는 다음의 경우는 다르다.


int f(std::shared_ptr<int> spw);

template<typename FuncType,
 typename PtrType>
decltype(auto) templateFunc(FuncType func, // C++14
 PtrType ptr)
{
 return func(ptr);
}

auto result = templateFunc(f, 0);

이 경우는 PtrType이 int가 되고, func에 int type을 넘겨주려 했기 때문에 컴파일 에러가 발생한다.


아까랑 뭐가 다른거지? 라고 생각할 수도 있는데, f(1)은 컴파일 에러가 발생하는 이유와 같다.


f(0)을 직접적으로 호출하면 마지못해 null ptr로 변환하지만, 템플릿을 사용하면 명확한 타입 추론이 먼저 발생하므로, 0을 인자로 넘긴다 한들 0을 null ptr로 해석하는 특수성을 고려하지 않는 것이다!


요약

  • nullptr를 쓰면 pointer와 integral type의 overload 상황에서 pointer를 인자로 갖는 함수를 호출할 수 있고, 코드의 가독성이 좋아지며, 템플릿을 사용할 때도 의도한 대로 동작할 수 있다. 따라서 nullptr을 쓰자!
  • 그럼에도 불구하고 integral과 pointer type에 대해서 overloading은 피하자.

이번 항목은 object initialize를 할 때 소괄호 ()와 중괄호 {}를 구분해서 사용해야 한다는 내용이다. 정확히는 언제 둘이 다른 결과를 내는지를 구분해야 한다.

그런데 책 내용이 c++17에서는 달라진 내용도 있고(std::atomic<int> a = 3;이 c++17부터는 에러를 발생하지 않는다), c++11에서도 error를 낸다고 돼있는데 실제로 컴파일해 보면 warning만 내는 경우도 있고,, 그래서 중요한 것 위주로 정리해 보려고 한다.


c++11에서 object initialization 방법은 크게 3가지가 있다.


int x(0); // 소괄호
int y = 0; // = 사용
int z{ 0 }; // 중괄호. int z = { 0 };과 동일

이 중 {}를 이용한 방법은 uniform initialization, 또는 braced initialization이라고 불리는데, 컨셉적으로는 어디에나 사용될 수 있고 모든 걸 표현할 수 있어서 그렇다고 한다.


{}를 이용한 initialization의 장점


예를 들어서, 다음과 같은 것이 가능하다.

std::vector<int> v{ 1, 3, 5 }; // v는 1, 3, 5를 가진 vector

또한, 다음과 같은 클래스 내의 default initialization이 가능하다.

class Widget {
 …
private:
 int x{ 0 }; // fine, x's default value is 0
 int y = 0; // also fine
 int z(0); // error!
};

여기서 z(0)처럼 소괄호 ()를 이용한 default initialization은 안된다.

아무튼 중괄호는 이처럼 여기저기 쓰일 수 있다.


중괄호 initialization의 장점은 또 있다. 바로 implicit 'narrowing conversion'을 막아 준다는 것이다. narrowing conversion은 변환 시 값의 손실이 일어날 수 있는 변환을 말한다. (double -> int 변환 때 소수점 아래가 버려지는 것 등등)


예를 들어, 다음과 같다.

double x = 2.3;
int y{x}; // warning or error

책에서는 에러가 발생한다고 돼있는데, 나는 직접 해보니 warning만 나왔다. 찾아보니 컴파일러마다 다를 수 있다고 한다. 에러를 내기 위해서는 -Werror=narrowing 옵션을 추가하자.


중괄호의 또다른 장점은, class의 default ctor를 호출하고 싶은데 function declaration을 하는 경우를 막아주는 것이다. c++의 most vexing parse라 한다.

예를 들면 다음과 같은 경우이다.

Widget w1(); // Widget을 return하는 함수를 선언한다.
Widget w2{}; // Widget의 default ctor
Widget w3; // ditto

w1은 함수가 돼버리는 황당한 경우가 발생한다. 이런 경우를 막기 위해서는 중괄호를 쓰거나 아예 괄호를 안 쓰면 된다.


아무튼 여기까진 중괄호 initialization의 범용성과 장점에 대해 살펴봤는데, 단점..이라기보단 주의해야 할 점이 있다.

바로 class의 ctor가 std::initializer_list를 인자로 받는 경우인데, 이 때 만약 중괄호를 사용한 initializtion을 하면 다른 overloaded ctor보다 상당한 우선순위를 갖게 된다.


{}를 쓸 때 주의: std::initializer_list를 받는 constructor

우선 auto를 쓸 때 {}를 쓰면 std::initializer_list로 초기화된다는 점은 유의해야할 점이다. 이는 [항목 2]를 참고하도록 하자.


그 다음,

class Widget {
public:
 Widget(int i, bool b); // as before
 Widget(int i, double d); // as before
 Widget(std::initializer_list<long double> il); // added
 
 operator float() const; // float로의 conversion
 …
};

이와 같은 Widget class가 존재한다고 하자. 다음의 경우는 모두 std::initializer_list를 인자로 갖는 ctor를 호출한다.

Widget w1{10, true};
Widget w2{10, 5.0};
Widget w3{w2}; // copy ctor가 불리지 않는다! float로의 변환 후 long double로 변환
Widget w4{std::move(w2)}; // move ctor가 불리지 않는다!

std::initializer_list는 long double을 원소로 갖는데, int건 bool이건 심지어 float로의 변환이 존재하면 copy ctor, move ctor까지 깡그리 무시하고 std::initializer_list ctor를 부른다. 참으로 무서운 일이 아닐 수 없다...


심지어 std::initializer_list<bool>을 parameter로 가질 때, w1{10, 2.0}을 부르면 narrowing conversion 에러를 내버리기까지 한다...


아예 변환이 불가능한, std::intializer_list<string>일 때가 돼서야 비로소 w1{10, 2.0}이 int, double ctor를 부른다.


근데 또 empty initializer_list를 이용하여 std::initializer_list ctor를 부르고 싶으면 다음과 같이 써야 한다.

Widget w1{{}};
Widget w2({});

Widget w3{}; // default ctor

w3처럼 쓰면 default ctor를 부른다. 이건 또 골치 아픈 예외인 듯하다.. 중괄호를 쓰면 깡그리 다 무시하고 std::initializer_list ctor를 부르더니, 정작 empty initializer_list는 default ctor를 부르니.. 아무튼 알아두자.


어쨌든 이러한 주의사항이 적용되는 대표적인 예가 std::vector class이다.

std::vector<int> v1(10, 20); // 10개의 원소의 값이 20으로 초기화된다.
std::vector<int> v2{10, 20}; // 2개의 원소의 값이 10, 20으로 초기화된다.

std::vector는 std::initializer_list를 받는 ctor가 존재하기 때문에 v2는 {10, 20}을 원소로 갖는 vector가 된다.


교훈

그래서, 이 챕터에서 얻어갈 것은 무엇인가?


우선, class author 입장에서는, std::initializer_list를 받는 constructor를 작성하는 것에 대해 조심해야 한다. 처음부터 그런 ctor가 있었으면 모르는데, 만약 없었는데 추가하는 입장이라면? 이미 그 클래스를 사용하는 사용자들이 {}를 이용하여 initialization했던 객체들이 갑자기 std::initialzer_list를 받는 ctor로 initialization될 수 있다. 아니 그럴 가능성이 매우 높다. 왜냐하면 std::initialization_list를 받는 ctor는 너무 강력하기 때문이다!


class client 입장에서는,  소괄호 ()와 중괄호 {} 중에 뭘 써야 할까? 정해진 답은 없다.


()를 주로 쓸 때의 장점은 C++98과 일관성이 있고, auto x{3}; 등을 선언할 때 std::initializer_list로 초기화되는 현상을 막을 수 있다는 점이다. 단점 및 유의할 점은 default ctor를 부를 때 function을 선언하지 않도록 조심해야 하며, non-static member variable을 초기화할 수 없다는 점에 유의해야 하고, narrowing conversion의 위험에 처한다. 또 {}를 써야만 할 때가 있다는 점을 알아야 한다.(vector<int> v{1, 2, 3} 등).


{}를 주로 쓸 때의 장단점은 ()를 쓸 때의 장단점과 반대이다. 장점은 높은 범용성과 narrowing conversion을 막아준다는 것, default ctor를 부를 때 주의하지 않아도 된다는 점. 단점 및 유의할 점은 auto와 같이 쓸 때 std::initializer_list가 된다는 것에 유의해야 하며, ()를 써야만 할 때가 있다는 점(vector<int> v(10, 20) 등)이 있다.


한편 template author 입장에서는 머리가 아플 수 있는데, template 안에서 객체를 생성할 때 ()를 쓸지 {}를 쓸지 선택해야 한다는 점이다. client가 객체를 만들 때야 알아서 의도대로 만들라고 할 수 있지만, template author 입장에서는 client가 무슨 의도로 만들지 알 수가 없으니 말이다.


예를 들어서

template<typename T, // type of object to create
 typename... Ts> // types of arguments to use
void doSomeWork(Ts&&... params)
{
 1. T localObject(std::forward<Ts>(params)...);
 2. T localObject{std::forward<Ts>(params)...);
}

doSomeWork에서 T타입의 객체를 만들 때, ()를 사용해야 할까 {}를 사용해야 할까?

doSomeWork<std::vector<int>>(10, 20); 라고 client가 부를 때 무슨 의도로 불렀는지에 따라 다른데, author 입장에서 그걸 알 수가 없다. 이는 std::make_unique와 std::make_shared에서 맞닥뜨리는 문제인데, 얘네는 ()를 쓴다고 한다.

Modern C++에서 auto는 편리하면서 중요하게 알아둬야 할 feature이다.


auto 사용에 있어서 장점을 먼저 살펴보자.

auto의 장점


우선 간단한 장점 하나는, 타입 추론을 해야 하기 때문에 uninitialized 될 위험을 없앤다는 것이다.(안 그러면 컴파일러 오류를 발생시키므로!)

int x;
auto x; // error!

다음의 장점은, closure 등에 대해서 매우 간단하게 표현을 가능하게 해준다는 것이다. 예를 들어서 다음과 같은 lambda 표현식을 정의할 수 있다. (lambda 식 안의 parameter를 auto로 선언 가능한 건 C++14부터 가능하다.)

auto derefLess = [](const auto& p1, const auto& p2)
{ return *p1 < *p2; }; // C++14

p1, p2에 대해서 dereference를 한 뒤 대소를 비교하는 간단한 함수인데, 이것을 auto를 쓰지 않고 쓴다면..

std::function<bool(const std::unique_ptr<Widget>&, const std::unique_ptr<Widget>&)>
 derefUPLess = [](const std::unique_ptr<Widget>& p1, const std::unique_ptr<Widget>& p2)
 { return *p1 < *p2; };

이와 같이 무시무시한 lambda 표현식이 탄생한다.


그래도 쓸 순 있는게 어디야?라고 생각할 수 있지만, 뒤의 std::function을 이용한 식은 심지어 auto로 표현한 식보다 메모리도 더 많이 잡아먹을 수 있고, 속도도 느릴 수 있다고 한다. 왜냐하면 auto를 이용하여 표현하면 딱 필요한 만큼만 메모리를 잡아먹는데 비해, std::function은 함수의 signature와 관계없이 정해진 메모리를 잡아먹고, 이는 비효율성을 야기시킬 수 있다는 얘기이기 때문이다. 또한 여러 내부 구현 등에 의해 std::function을 사용하면 거의 auto 표현식보다 느리다고 한다.


간단하고, 메모리도 효율적이고, 속도도 빠르니 auto를 안 쓸 이유가 없다!


또 다른 장점은, 타입을 정확하게 추론하기 때문에 예기치 못한 에러를 미연에 방지할 수 있다. 예를 들어서,

std::vector<int> v;

unsigned sz1 = v.size();
auto sz2 = v.size(); // std::vector<int>::size_type

위 코드를 보자. 보통 std::vector<int>의 size 함수의 return type이 std::vector<int>::size_type이란걸 신경 쓰면서 코딩을 하진 않는다. 실제로 보통의 경우 unsigned로 받아도 큰 문제는 없을 수 있지만, 64비트 windows 운영체제에서 unsigned는 4byte인데 반해 std::vector<int>::size_type은 8byte이다. 이는 언젠가 큰 버그를 야기시킬 수 있는데, 분명 잡아내기 쉽지 않을 것이다!


std::unordered_map<std::string, int> m;

for (const std::pair<std::string, int>& p : m)
{
 … // do something with p
}

또, 위 코드를 보자. 언뜻 보기에 문제없는 코드 같지만, 위 코드는 비효율적으로 돌아갈 수 있다. 왜냐하면 unordered_map의 key 부분은 const이기 때문에, for 문을 돌 때 std::pair<const std::string, int>로 해야 맞기 때문이다. 물론 저렇게 해도 돌아갈 테지만, temporary object를 생성하고 파괴되는 비효율적인 동작을 하게 된다. unordered_map의 key가 const임을 놓치면 비효율적인 코드를 쓸 수 있는 것이다. 따라서 다음과 같이 쓰자.

for (const auto& p : m)
{
 … // as before
}

이렇게 했을 때의 또다른 장점은, p의 주소가 실제 m의 element의 주소를 나타낸다는 것이다. 만약 std::pair<std::string, int>로 받았으면 temporary object의 주소를 가리켰을 것이고, 그것은 파괴될 객체의 주소이기 때문에 undefined behavior를 야기시킬 수 있을 것이다.


여기까지 auto의 장점을 알아봤다. 하지만 auto를 사용할 때 주의해야할 점을 알아두는 게 좋다.

auto 사용 시 주의할 점: invisible proxy class


auto가 타입을 너무 정확하게 추론해서 오히려 주의해야 한다!


std::vector<bool> features(const Widget& w);

Widget w;
…
bool highPriority = features(w)[5]; // is w high priority?
…
processWidget(w, highPriority);

위와 같은 코드를 보자. features는 Widget을 받아서 Widget의 특성을 std::vector<bool>로 return 하는 함수이다. return값의 index 5가 Widget의 priority를 나타낸다고 생각하자.


그런데 위 코드에서 highPriority를 auto로 받으면 어떻게 될까?

auto highPriority = features(w)[5];
processWidget(w, highPriority) // undefined behavior!!!

놀랍게도 processWidget은 undefined behavior를 나타내게 된다. highPriority가 더 이상 priority를 나타내지 않을 수 있기 때문이다!


이는 std::vector<bool>의 operator[]가 vector 원소의 reference를 return하지 않기 때문이다. std::vector<bool>의 operator[]는 std::vector<bool>::reference를 반환한다. (이런 이상한 동작은 std::vector에서는 <bool>에 대해서만 그렇게 동작한다. 다른 모든 타입에 대해서는 그대로 reference를 반환한다. 이유는 원래 bool은 1byte를 잡아먹는데, vector가 bool에 대해서 효율적으로 동작하게 하기 위해 1bit씩 저장하게 만들었기 때문이다!)


하지만 일반 사용자 입장에서 이것을 알아둘 필요는 없었다. 왜냐하면 bool로 받았다면 implicit conversion이 일어났을 것이고, 우리는 그냥 그대로 쓰면 된다. 그리고 이것이 라이브러리 제작자가 의도한 바일 것이다.


하지만 우리의 auto는 너무 똑똑한 나머지, features(w)[5]의 타입을 std::vector<bool>::reference로 그대로 추론을 하고 만다. 그렇다면 highPriority가 갖는 값은 무엇이 될까? std::vector<bool>::reference의 구현 방식에 따라 달라질 수 있는데, 예를 들어 reference bit의 pointer를 가질 수 있다. 그런데 features(w)는 rvalue이므로 바로 파괴될 것이고, 따라서 파괴된 객체의 pointer를 가리키므로, dangling pointer가 돼버릴 수 있다!


auto 하나 썼다고 dangling pointer 문제를 맞닦뜨리게 될 줄은 몰랐을 것이다..


이러한 일이 발생한 이유는 std::vector<bool>::reference가 proxy class이기 때문이다. proxy class에 대해서는 나중에 다시 알아보도록 하자. unique_ptr이나 shared_ptr도 proxy class의 일종이라고 한다.

문제는 std::vector<bool>::reference가 invisible proxy, 즉 사용자가 모르는 걸 전제로 만들어진 proxy class라는 것이다. 이 class는 애초에 conversion이 일어날 것이라고 가정하고 설계된 class이기 때문에, lifetime이 한 줄보다 길어지면 undefined behavior를 나타낼 수 있다. 그런데 auto가 그 타입을 정확하게 추론해 버려서 문제가 되는 것이다.


Matrix sum = m1 + m2 + m3 + m4;

위와 같은 코드에서도 비슷한 문제가 발생할 수 있다. Matrix의 + operator가 Matrix를 반환하는게 아니라 Sum<Matrix, Matrix> 와 같은 proxy class를 반환하면 더 효율적일 수 있는데, 저걸 Matrix가 아니라 auto로 받아버리면 비슷한 문제가 생길 수 있다.


기억해야 할 것은 invisible proxy class는 auto와 상성이 안 좋다는 것이다!


아무튼 저자는 이것을 해결하기 위해 explicitly typed initializer idiom을 사용하라고 한다. auto를 쓰되, static_cast와 같이 type을 explicit하게 명시하라는 것이다. 

auto highPriority = static_cast<bool>(features(w)[5]);

auto sum = static_cast<Matrix>(m1 + m2 + m3 + m4);

이렇게 명시적인 type casting을 나타냄으로써 위의 invisible proxy class의 문제를 해결할 수 있다!


요약

  • auto는 편리하고, 타입을 정확하게 추론하며, 효율적이며 빠르게 동작하게 도와줄 수 있는 등 여러 장점을 가지고 있다.
  • invisible proxy일 때는 explicit하게 casting해서 써야 한다.

decltype은 쉽게 말해서 변수나 함수의 타입을 말해주는 것이다.

단, 타입을 우리가 볼 수 있게 출력해 준다거나 하진 못하고, 컴퓨터가 이해할 수 있는 타입으로 치환된다고 보면 된다.


예를 들어,

int x = 0;

decltype(x) y = 0; // int y = 0;

다음과 같이 쓸 수 있는 것이다.


그렇다면 주된 사용처는 어디일까?

C++11에서는 주로 함수의 return 타입이 parameter 타입에 의존적인 function 템플릿을 선언할 때 쓰인다. 예시를 보자.

template<typename Container, typename Index>
auto authAndAccess(Container& c, Index i)
    -> decltype(c[i])
{
    authenticateUser();
    return c[i];
}

auto만 쓰면 되는거 아냐?라고 생각할 수 있는데, 그건 C++14부터 지원한다. C++11에서 함수의 return 타입의 auto는 타입 추론을 하지 못한다. 그냥 trailing return type(함수의 return 타입이 parameter 선언 후에 나오는 것)을 쓴다고 알려주는 역할일 뿐이다.


왜 저런식으로 할 수밖에 없냐 하면,, 함수의 return 타입이 parameter에 의존적이기 때문이다. 일단 parameter가 선언이 돼야 그걸 쓸 수 있을 테니, 저렇게 ->를 써서 뒤에 나타내는 것이다.


C++14에서는 그냥 다음과 같이 쓸 수 있다.

template<typename Container, typename Index>
auto authAndAccess(Container& c, Index i)
{
    authenticateUser()l
    return c[i];
}


그런데 위의 C++14 authAndAccess 함수는 상황에 따라 우리가 원하는 동작을 하지 않을 수 있다!

왜냐하면, 함수의 return 타입에서의 auto는 템플릿 타입 추론을 하고, 따라서 reference를 무시하기 때문이다.([항목 2] 참고)

이게 왜 문제가 될까?


예를 들어 다음과 같은 코드를 보자.

std::deque<int> d;
authAndAccess(d, 5) = 10; // error

위 코드는 컴파일이 되지 않는다. 왜냐하면 authAndAccess(d, 5)의 타입은 int&가 아니라 int이기 때문이다.

d[5]가 원래 3이었다면, 우리가 원하는 동작은 d[5] = 10; 이지만, 위 코드는 3 = 10; 처럼 해석이 된다.

lvalue reference가 아니라 rvalue이기 때문에 문제가 되는 것이다.


우리가 원하는 동작을 하게 만들기 위해서는 decltype을 사용하면 된다. decltype은 정확한 타입 추론을 하기 때문이다. C++14에서는 그래서 decltype(auto)를 사용하여 다음과 같이 쓰면 된다.

template<typename Container, typename Index>
decltype(auto) authAndAccess(Container& c, Index i)
{
    authenticateUser();
    return c[i];
}


이제 모든게 해결된 것처럼 보이지만..  위 함수는 여전히 문제를 일으킬 수 있다. 그건 바로  rvalue container를 authAndAccess의 인자로 넣을 때다. 문제 하나를 해결했더니 다른 문제가 생겼다..


authAndAccess 함수는 container를 Container&, 즉 lvalue-reference-to-non-const로 넘긴다. 이 경우는 rvalue container를 제대로 넘길 수 없다는 의미이다(const Container&면 가능한 듯하다. 이 부분에 대해서는 나중에 더 알아보자!).


예를 들어 다음과 같은 코드를 보자.

std::deque<std::string> makeStringDeque(); // factory 함수

auto s = authAndAccess(makeStringDeque(), 5);

makeStringDeque는 string deque를 만들어주는 함수이다. 이 함수를 바로 authAndAccess의 인자로 넘겼기 때문에, deque 객체가 만들어졌다가 바로 파괴될 것이다. 그런데 authAndAccess의 return 타입은 string&, 즉 reference이기 때문에, s는 파괴된 deque의 원소를 가리킬 것이다. 마치 dangling pointer와 같은 위험한 상황이 발생한 것이다.


이를 해결하는 한 방법은 lvalue reference parameter와 rvalue reference parameter를 인자로 같는 두 함수를 각각 만드는 것이지만, 그보다 좋은 방법은 universal reference를 사용하는 것이다. [항목 24]와 [항목 25]를 참고하면 완성형의 C++14 authAndAccess 함수는 다음과 같다.

template<typename Container, typename Index>
decltype(auto) authAndAccess(Container&& c, Index i)
{
    authenticateUser();
    return std::forward<Container>(c)[i];
}

C++11 버전의 authAndAccess 함수는 다음과 같다.

template<typename Container, typename Index>
auto authAndAccess(Container&& c, Index i)
    -> decltype(std::forward<Container>(c)[i])
{
    authenticateUser();
    return std::forward<Container>(c)[i];
}

decltype 주의사항

decltype을 사용할 때 주의해야 할 사항이 있다. 이것 때문에 문제를 일으킬 경우는 거의 없지만, 모르면 언젠간 머리를 쥐어뜯을 수 있다고 한다.


decltype이 이름을 소괄호 ()로 감싼 표현에 대해 추론을 할 경우, 항상 lvalue reference로 타입을 추론한다!


다음과 같은 함수를 보자.

decltype(auto) func()
{
    int x = 0;
    return (x);
}

위 함수는 매우 위험한 함수이다. 왜냐하면 decltype((x))는 int&이고, 따라서 func 함수 내의 로컬 변수인 x의 위치를 참조하기 때문이다. func 함수가 return함에 따라 x는 파괴되고, func의 return 값은 파괴된 x의 reference를 가리키게 된다.

이 글을 보기 전에 [항목 1]을 읽고 오면 좋다.

링크 - [항목1: 템플릿 타입 추론 이해]


[Effective Modern C++] 항목 1: 템플릿 타입 추론 이해

템플릿 타입 추론은 C++11의 주요 feature 중 하나인 auto 타입 추론의 기반이기 때문에 잘 이해해야 한다. function template은 다음과 같이 선언 및 호출할 수 있다. // Pseudo Code // Declaration template void f(Para

kwak-story.tistory.com

auto 타입 추론은 템플릿 타입 추론과 거~의 같다.

auto x = 27;
const auto cx = x;
const auto& rx = x;

여기서 auto의 타입 추론은 다음과 같다고 볼 수 있다.

template<typename T>
void func_for_x(T param);

func_for_x(27);


template<typename T>
void func_for_cx(const T param);

func_for_cx(x);


template<typename T>
void func_for_rx(const T& param);

func_for_rx(x);

결국 auto 앞에 붙는 const나 레퍼런스 등은 ParamType이고, 실제로 auto가 추론되는 것은 T인 것이다.

그리고 = 뒤에 오는 27, x는 argument의 역할을 한다.


[항목 1]에서 3 가지 케이스로 나눴었는데, x와 cx는 케이스 3이고, rx는 케이스 1이다.


케이스 2에 대해서도 예시를 들자면

auto&& uref1 = x;
auto&& uref2 = cx;
auto&& uref3 = 27;

universal 레퍼런스이므로 lvalue, rvalue를 구분하는게 중요하다.

x와 cx는 lvalue이므로 uref1은 int&, uref2는 const int&로 추론된다.

27은 rvalue이므로 uref3은 그냥 int&&가 되는 것이다.


이처럼 템플릿 타입 추론과 auto 타입 추론은 동일하다. 단 한 가지 예외를 제외하면!


예외사항

auto 타입 추론은 중괄호로 initialization하는 것을 std::initializer_list로 추론하는 반면, 템플릿 타입 추론은 추론을 못 한다.


C++11에선 uniform initialization을 지원한다. 즉,

// C++98
int x1 = 27;
int x2(27);

// C++11
int x3 = { 27 };
int x4{ 27 };

중괄호 {}를 통한 initialization을 지원한다.


int 대신 auto를 쓰면 어떨까. [항목 5]에서 추후 나오겠지만, auto로 타입을 선언하는 것에는 장점이 여럿 있다. 따라서 다음과 같이 써보자.

auto x1 = 27;
auto x2(27);
auto x3 = { 27 };
auto x4{ 27 };

넷 다 컴파일이 정상적으로 되지만, 중괄호 {}를 쓴 세 번째, 네 번째의 auto는 int가 아니라 std::initializer_list<int>로 추론된다!!


auto로 선언된 변수가 중괄호로 감싸져 있을 경우, 타입 추론은 std::initializer_list<T>로 된다.

만약 중괄호 안의 변수들의 타입이 다른 경우, 컴파일 에러가 날 것이다.

auto x5 = { 1, 2, 3.0 }; // error! can't deduce T for std::initializer_list<T>

아무튼, auto는 중괄호로 선언하는 것을 std::initialized_list로 추론한다는 것을 알았다. 하지만 템플릿 타입 추론에서는 다르다. 다음과 같은 코드는 컴파일 에러를 낼 것이다.

template<typename T>
void f(T param);

f({ 11, 23, 9 }); // error!

템플릿 타입 추론은 중괄호로 감싸진 argument를 std::initializer_list로 추론하지 못한다. 다음과 같이 명시적으로 선언을 할 경우는 가능하다.

template<typename T>
void f(std::initializer_list<T> initList);

f({ 11, 23, 9 }); // T는 int로 추론된다.

왜 auto 타입 추론은 중괄호에 대해 std::initizerlizer_list로 추론하고, 템플릿은 그렇지 않을까? 딱히 이유는 없다고 한다.. 그냥 특별한 예외이므로 알아둬야 한다!


아마 auto로 중괄호 선언을 해서 의도치 않게 std::initializer_list로 잘못 추론을 하게 하는 실수가 많이 나올 수 있을 것 같다. 주의하자!


C++14에 대해서는 추가적으로 알아둘 내용이 있다.


C++14는 함수의 리턴 타입을 auto로 설정하는 것이 가능하다. 하지만 이때의 auto 추론은 템플릿 타입 추론을 따른다. 즉, 다음과 같은 함수는 컴파일 에러를 발생시킨다!

auto createInitList() {
    return { 1, 2, 3 };		// error! { 1, 2, 3 }에 대한 타입 추론 불가
}


또, C++14에서 lambda는 parameter 선언에서 auto를 쓸 수 있지만, 이때도 auto 추론은 템플릿 타입 추론을 따른다. 즉, 다음과 같은 lambda 사용은 역시 컴파일 에러를 발생시킨다!

auto resetV = [&v](const auto& newValue) {
    v = newValue;
};

resetV({ 1, 2, 3 });	// error! { 1, 2, 3 }에 대한 타입 추론 불가


요약

  • auto 타입 추론은 템플릿 타입 추론과 보통 같다. 예외는, auto 타입 추론은 중괄호 initialization을 std::initialzer_list로 추론하는 반면, 템플릿 타입 추론은 그렇지 않다는 것이다(컴파일 에러를 낸다).
  • [C++14] auto가 함수 리턴 타입에 들어가거나 lambda parameter로 사용되는 경우 템플릿 타입 추론을 따른다. 즉 중괄호를 std::initializer_list로 추론하지 못한다!

윈도우에서 OpenGL 개발환경을 구축하기 위한 글.


빌드를 위해 Visual Studio와 CMake가 필요하다.


Visual Studio는 이미 설치되어 있다고 가정하겠다.


OpenGL 3.3 기준으로 설정해 보자.


순서는 CMake 설치 -> GLFW 설치 -> GLAD 설치 순으로 진행해 보자.


CMake 설치

https://cmake.org/download/

위 링크에 접속한다.

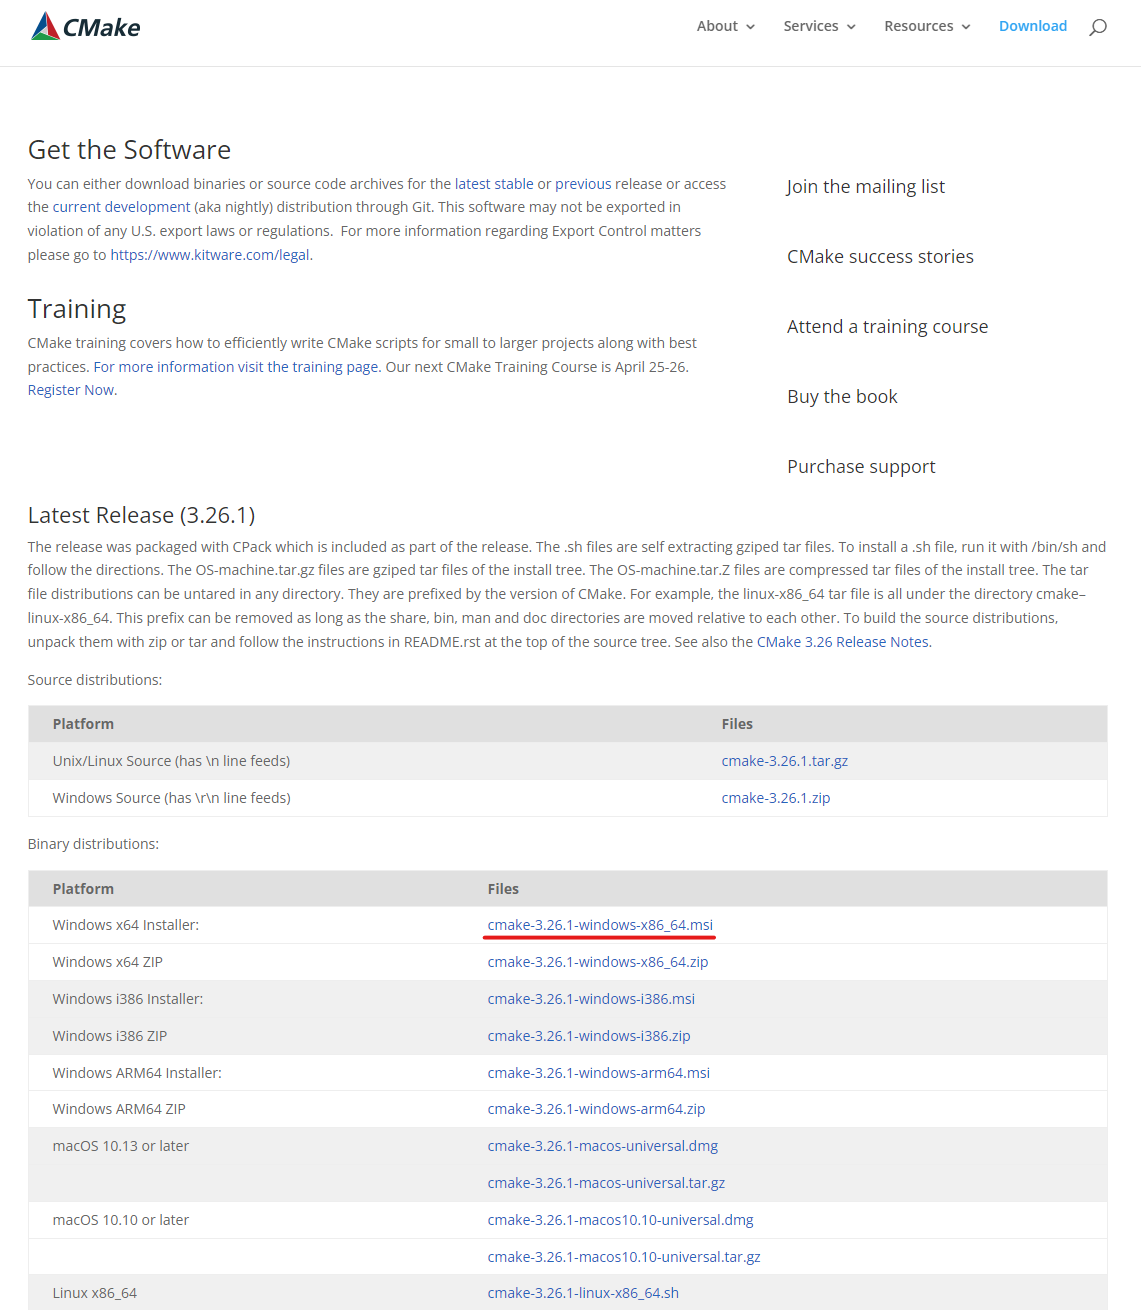
CMake 다운로드 페이지

윈도우 64bit 운영체제 기준으로 밑줄 친 링크 클릭.

msi 파일 실행

다운로드 후 msi 파일을 클릭하고 Next를 계속 눌러 설치를 완료한다.


GLFW 설치

https://www.glfw.org/download.html


Download

GLFW source code and binary distribution download links.

www.glfw.org

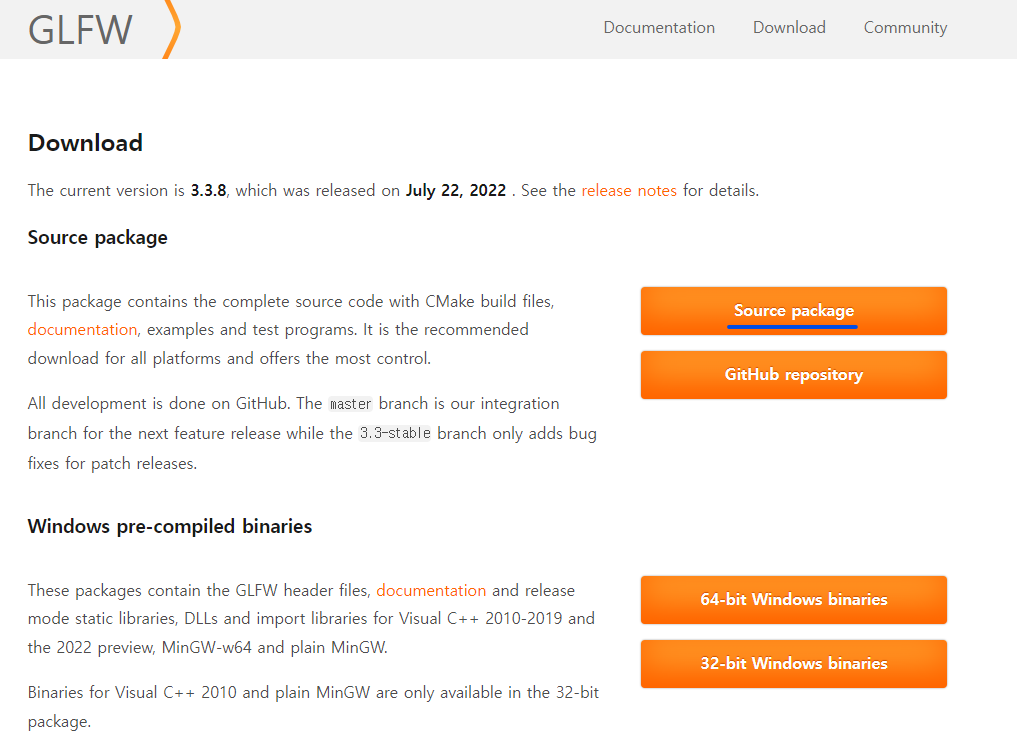
위 링크에서 파란색으로 밑줄 친 Source package를 클릭해서 zip 파일을 다운받은 후 압축을 푼다.

GLFW 다운로드 페이지


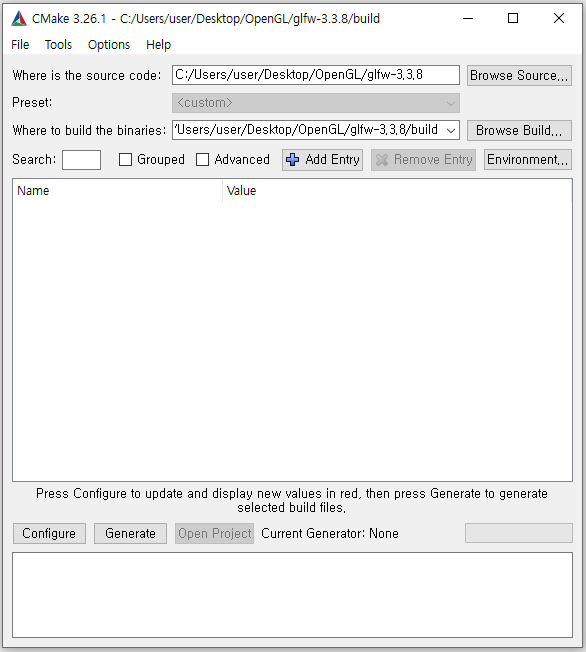
이후 미리 설치한 CMake gui 실행.

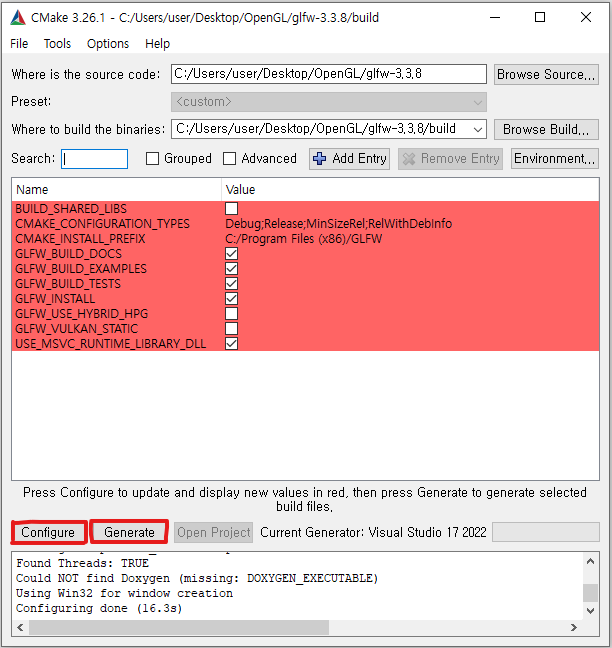
Browse Source를 눌러 glfw-3.3.8을 압축 해제한 폴더를 선택한다.

그 후에 밑에 빌드할 폴더를 선택하면 되는데, 통상적으로 많이 하듯이 build폴더를 새로 만든 후 Browse Build를 눌러 그 폴더를 선택한다. 이후 Configure를 누른다.

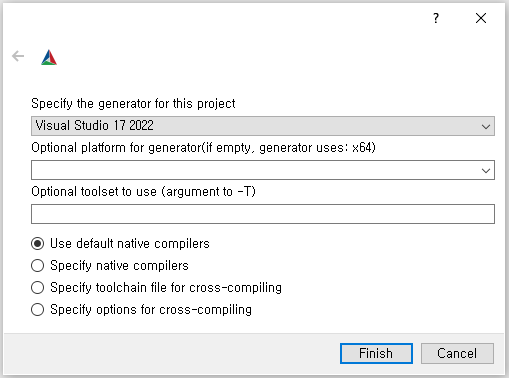
자신의 컴퓨터에 설치되어 있는 Visual Studio 버전에 맞게 선택하고, Finish를 누른다.

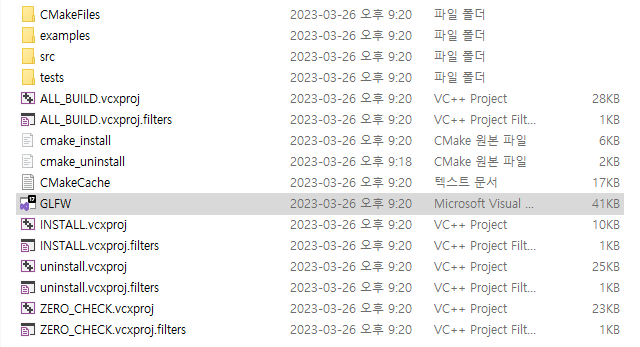
저렇게 빨갛게 뜨면 Configure를 다시 누르고 Generate를 누르면 build 폴더 안에 GLFW 솔루션 파일이 다음과 같이 생성된다.

glfw-3.3.8/build

이후 GLFW.sln을 더블클릭해서 열고 ctrl+shift+b를 눌러 빌드하면 

glfw-3.3.8/build/src/Debug

저렇게 build/src/Debug에 glfw3.lib이 생성된다.


우리에게 필요한 건 glfw-3.3.8 안의 include 폴더와 빌드를 통해 생성된 glfw3.lib이다.

아무 폴더에 다음과 같이 include폴더와 lib 폴더를 만들고, include 폴더에는 glfw-3.3.8 안에 있던 include 폴더를 넣고, lib 폴더에는 glfw3.lib 파일을 넣자.

include 안의 헤더파일과 lib 안의 라이브러리 파일이 있지만, 우리의 Visual Studio가 헤더파일과 라이브러리 파일이 어디 있는지 알려주는 작업이 필요하다.


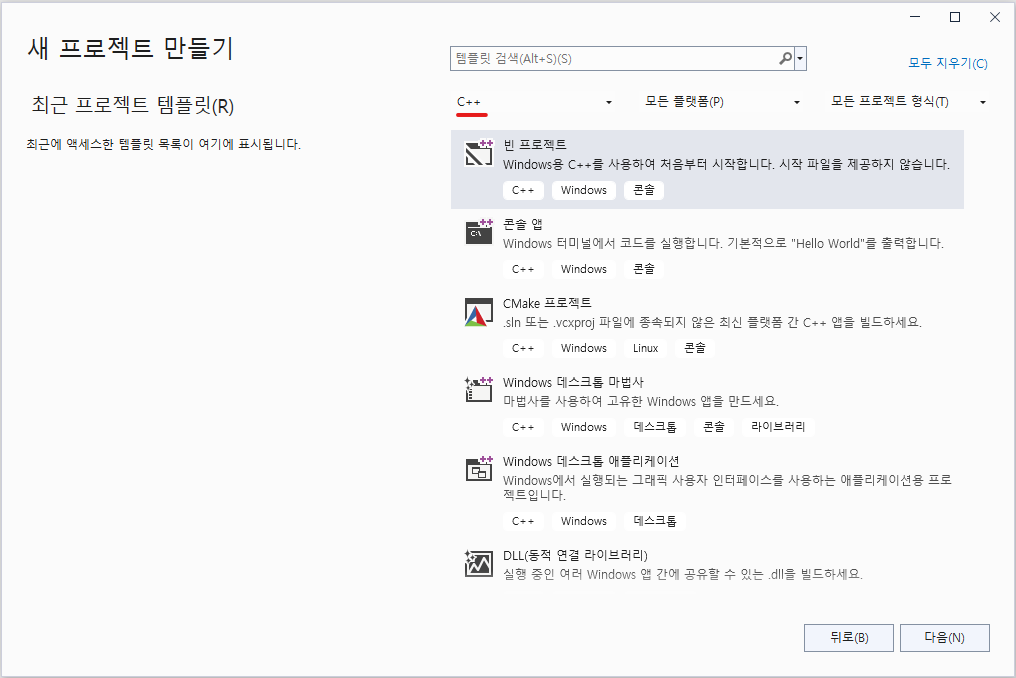
우선 빈 프로젝트를 만들어 설정을 해보자.

위와 같이 언어를 C++로 하고 빈 프로젝트를 만든다.


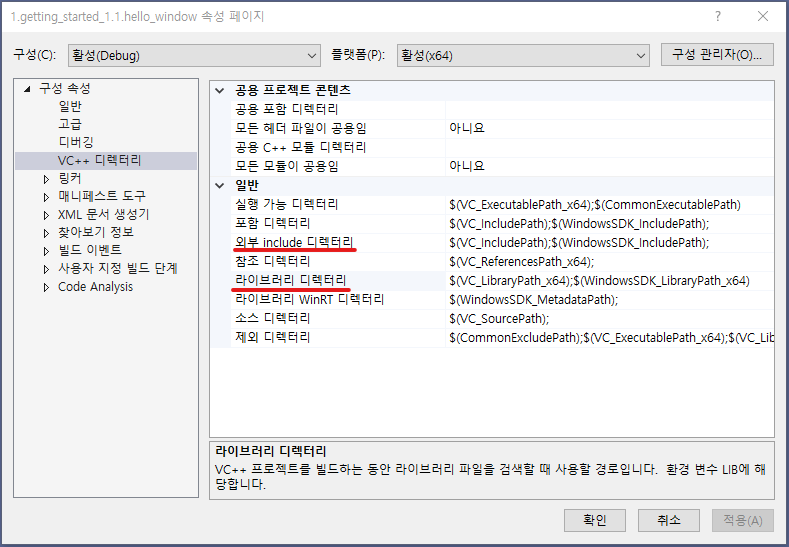
이후 Visual Studio 상단 탭의 프로젝트->속성 을 클릭하여 위 창을 띄우고, VC++ 디렉터리 탭을 클릭한다.

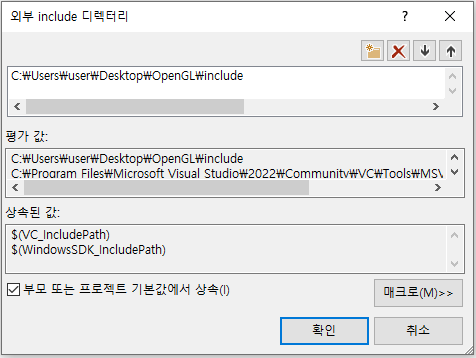
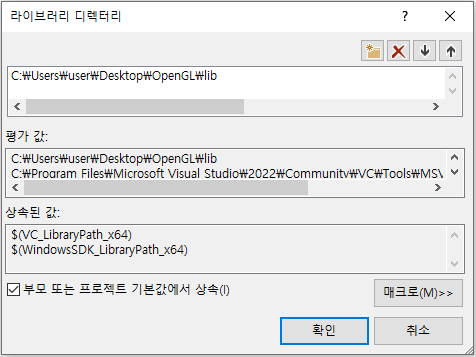
그 후 밑줄 친 외부 include 디렉터리와 라이브러리 디렉터리를 클릭하여 편집을 누른다.


아까 생성한 include와 lib 디렉터리를 각각 넣고 확인을 눌러준다.

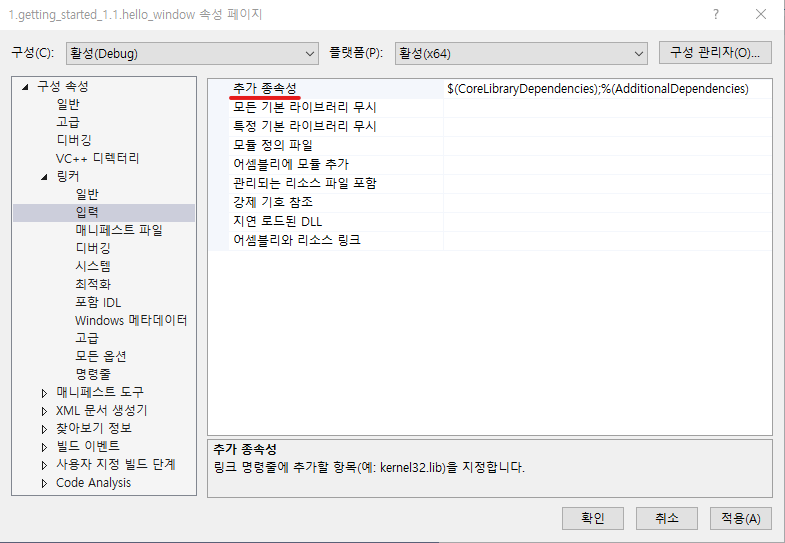
glfw3.lib이 lib 폴더에 있다는 것은 알려줬지만, 실제로 glfw3.lib을 링크하기 위해서는 종속성 설정을 해줘야 한다.

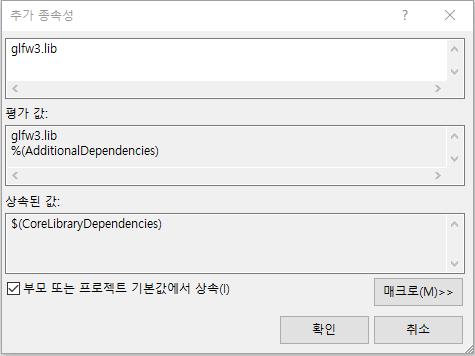
좌측의 링커 탭에 입력을 누르고, 밑줄 친 추가 종속성을 마찬가지로 편집해 준다.

glfw3.lib을 넣고 확인을 눌러 마무리한다. GLFW 설정 끝!


GLAD 설치

이제 GLAD를 다운받아 설정해보자. 밑의 링크에 들어가자.


https://glad.dav1d.de/


https://glad.dav1d.de/

Extensions...

glad.dav1d.de

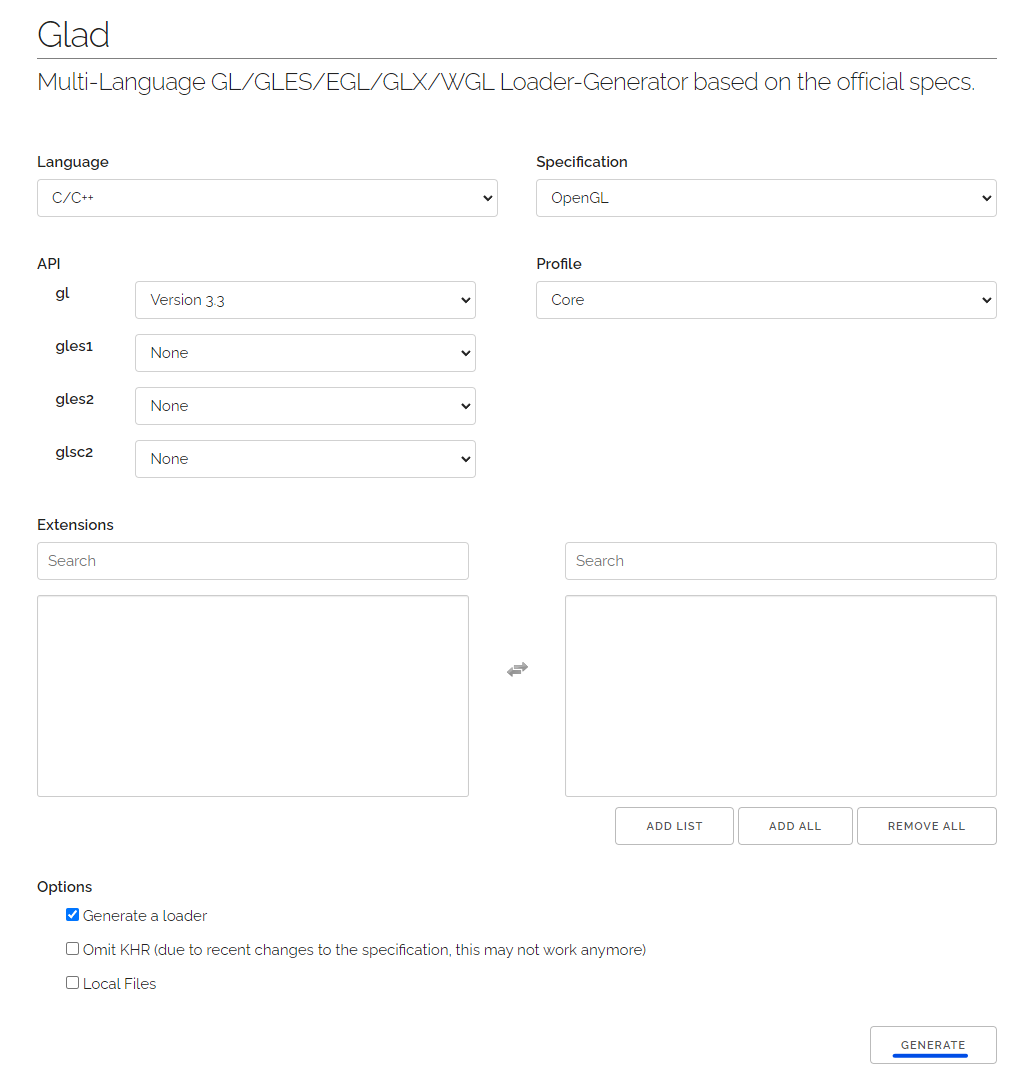
언어는 C/C++, gl 버젼은 3.3을 선택하고 Profile은 Core를 선택한 뒤 GENERATE를 누른다.

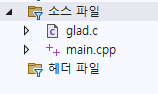
이후 glad.zip을 압축 푼 후, include 폴더 안의 내용물을 아까 만든 include 폴더 안에 집어넣고, src 안의 glad.c를 아래와 같이 프로젝트 소스 파일 안에 집어넣는다.

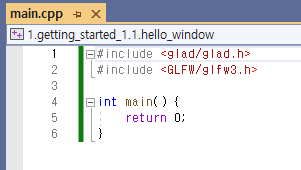
이후 main.cpp를 만들고 다음과 같이 작성 후 ctrl+F5를 눌러 문제없이 프로그램이 종료되는지 확인하면 끝!

이때 GLFW/glfw3.h보다 glad/glad.h를 먼저 include 해야 함에 주의하자!!

템플릿 타입 추론은 C++11의 주요 feature 중 하나인 auto 타입 추론의 기반이기 때문에 잘 이해해야 한다.


function template은 다음과 같이 선언 및 호출할 수 있다.

// Pseudo Code

// Declaration
template<typename T>
void f(ParamType param);

// Function call
f(expr);

이때, expr을 통해서 TParamType을 추론한다.  T와 ParamType은 같을 수도 있지만 다른 경우도 존재한다. 예를 들어,


// Declaration
template<typename T>
void f(const T& param);

// Fucntion call
int x = 0;
f(x);

위의 경우, ParamType은 const int&이고, T는 int이다.


T와 ParamType을 추론하기 위해서는 ParamType이 어떻게 생겼는지에 따라 3가지로 경우를 나누어 생각해야 한다.


  • Case 1: ParamType이 pointer나 reference 타입인 경우(universal reference인 경우는 제외).
  • Case 2: ParamType이 universal reference인 경우.
  • Case 3: ParamType이 pointer도, reference도 아닌 경우.

위에서 universal reference란 용어가 나오는데... 일단 그냥 그런게 있다 정도로 넘어가도 무방하다. 나중에 [항목 24]에서 나올 예정이라고 하니 조금만 기다려보자.


이제 3가지 Case에 대해 하나씩 살펴보자!


Case 1: ParamType이 pointer나 reference 타입인 경우(universal reference인 경우는 제외).


이 경우는, 다음과 같이 추론을 할 수 있다.


  1. 만약 expr의 타입이 reference인 경우, reference를 무시한다.
  2. expr의 타입을 ParamType에 대해서 패턴 매칭하고, T를 추론한다.


일단 1번은 expr, 즉 호출부의 reference를 무시한다는 얘기니 간단한데, 2번은 아직 감이 안올 수 있다.

중요한 것은.. T는 ParamType이 정해지면 저절로 추론이 된다는 것이다.

예를 들어, ParamType이 T&라 하자. 패턴 매칭을 통해 ParamType이 const int&로 정해졌다면, 자연스럽게 T는 const int로 추론된다는 것을 알 수 있다.


그렇다면 패턴 매칭을 어떻게 한다는건지 첫 번째 예제를 통해 살펴보자.


// Declaration
template<typename T>
void f(T& param);	// ParamType이 reference이다.

// Fucntion call
int x = 27;
const int cx = x;
const int& rx = x;

f(x);
f(cx);
f(rx);

ParamType이 reference인 경우다(호출부의 reference를 무시하는 것이지, ParamType의 reference를 무시하는게 아님에 주의하자!).

이때 3가지 expr이 나오는데,

x는 그냥 int,

cx는 const int,

rx는 const int&이다.


이 3가지 경우에 대해 타입 추론을 해보자.


1. x: int

추론 과정의 첫 번째는 호출부의 reference 무시인데, x는 int이므로 애초에 reference가 아니다. 따라서 바로 패턴 매칭으로 넘어가자.


// expr -> ParamType

int -> T&


ParamType이 int&가 될 수 밖에 없다는것을 쉽게 알 수 있다!(char&가 되진 않을거니까..)

따라서 ParamType은 int&이고, 저절로 T는 int가 된다.


2. cx: const int

cx 역시 reference가 아니므로 바로 패턴 매칭으로 넘어가보자.


// expr -> ParamType

const int -> T&


ParamType은 이때 const int&가 된다. 호출부의 const가 T로 그대로 넘어온 것이다! 이부분이 좀 헷갈릴 수도 있을 것 같은데, 호출부의 특성을 다 포함하는 방향으로 T가 ParamType이 정해진다고 보면 될 것 같다.


ParamType이 const int&이므로, 저절로 T는 const int가 된다.


3. rx: const int&

드디어 추론 과정의 첫 번째 과정이 쓰이는 경우이다. 호출부가 reference이므로, reference를 무시한다. 그러면 const int가 되므로, 위의 cx 추론 과정과 동일해진다. 따라서 T는 const int가 된다.


이제 두 번째 예제로 가보자. 다 동일한데, ParamType이 T&에서 const T&로 바뀌었다.

// Declaration
template<typename T>
void f(const T& param);	// ParamType이 const reference이다.

// Function call
int x = 27;
const int cx = x;
const int& rx = x;

f(x);
f(cx);
f(rx);

ParamType이 const reference로 바뀌었을 때 어떻게 되는지 살펴보자.


1. x: int

호출부가 reference가 아니니 바로 패턴 매칭으로 넘어가자.


// expr -> ParamType

int -> const T&


ParamType은 const int&가 될 수 밖에 없어보인다. 따라서 T는 저절로 int가 된다.


2. cx: const int

역시 호출부가 reference가 아니니 바로 패턴 매칭으로 넘어가자.


// expr -> ParamType

const int -> const T&


호출부가 const지만 애초에 ParamType도 const이다. ParamType은 const int&가 되고, 따라서 T는 저절로 int가 된다.


3. rx: const int&

호출부의 reference를 무시하므로 const int가 되고, 위의 cx 추론 과정과 동일하므로 T는 int가 된다.


첫 번째 예제와 두 번째 예제의 차이점에 주목하자. x에 대해서는 똑같이 T가 int로 추론되었지만, cx와 rx에 대해서는 결과가 다르다.


첫 번째 예제는 ParamType이 T&였던 경우였다. 이때 cx와 rx에 대해서 ParamType이 const int&가 되었기 때문에 T는 const int로 추론되었다.


반면 두 번째 예제는 ParamType이 const T&였으므로, cx와 rx에 대해서 ParamType이 const int&가 되어도 T는 그냥 int로 추론되었다.


ParamType에 const가 붙었냐에 따라 T가 int가 될 수도, const int가 될 수도 있다는 것을 알고 넘어가자!


Case 2: ParamType이 universal reference인 경우.


universal reference에 대해서 잘 몰라도, 여기서는 어떻게 추론되는지 핵심만 알고가자.


  1. 만약 expr가 lvalue라면, T와 ParamType은 둘 다 lvalue reference로 추론된다.
  2. 만약 expr가 rvalue라면, Case 1과 동일하다.


1번은 두 가지 측면에서 주목하고 넘어가야 한다.

첫 번째로, 템플릿 타입 추론에서 T가 reference로 추론되는 유일한 경우이다.

두 번째로, ParamType이 rvalue reference의 형태로 선언되었지만, 추론된 타입은 lvalue reference이다.


예제를 통해 어떻게 추론되는지 알아보자.


// Declaration
template<typename T>
void f(T&& param);	// ParamType이 universal reference이다.

// Function call
int x = 27;
const int cx = x;
const int& rx = x;

f(x);
f(cx);
f(rx);
f(27);​

1. x: int

x가 lvalue이므로, T와 ParamType 둘 다 int&로 추론된다.


2. cx: const int

cx가 lvalue이므로, T와 ParamType이 둘 다 const int&로 추론된다. 호출부의 const가 넘어오는 것은 Case 1과 동일하다.


3. rx: const int&

rx 역시 lvalue이므로, T와 ParamType이 둘 다 const int&로 추론된다.


4. 27: rvalue int

27은 rvalue이다. 따라서 Case 1과 동일하게 추론을 한다.


// expr -> ParamType

int -> T&&


ParamType은 int&&가 되고, 따라서 T는 저절로 int가 된다.


universal reference인 경우는 호출부가 lvalue인지, rvalue인지에 따라 다르게 추론된다는 것에 주목을 해야 한다. Case 1에서는 lvalue, rvalue 모두 동일한 규칙에 의해 추론되었었다. T가 reference로 추론되는 유일한 경우임을 알아두는 것도 중요해보이는 포인트이다!


Case 3: ParamType이 pointer도, reference도 아닌 경우.


즉, pass-by-value인 경우이다. 이 경우 규칙은 다음과 같다.


  1. 만약 expr의 타입이 reference인 경우, reference를 무시한다.
  2. 만약 expr의 reference를 무시했는데 expr가 const나 volatile인 경우, const와 volatile을 무시한다.


(volatile에 대해서는 [항목 40]에 나온다.)


사실 규칙이 저렇긴 한데, 결국 pass-by-value의 본질에 대해 생각해본다면 당연하게 느껴질 수 있다. 어차피 복사본이 들어가는데, 원본이 reference인지 const인지 알게 뭔감?


첫 번째 예제를 통해 살펴보자.

// Declaration
template<typename T>
void f(T param);	// pass-by-value이다.

// Function call
int x = 27;
const int cx = x;
const int& rx = x;

f(x);
f(cx);
f(rx);

x, cx, rx 모두에 대해 T와 ParamType은 모두 int이다.


함수의 argument, 즉 호출부가 const든 reference든, parameter로 넘어온 시점에서는 복사본이기 때문에 다 무시된다.


간단해 보이지만, 두 번째 예제를 통해 주의할 점을 살펴보자.


// Declaration
template<typename T>
void f(T param);	// ParamType이 universal reference이다.

// Function call
const char* const ptr =
  "Fun with pointers";
  
f(ptr);

어차피 pass-by-value니까 const 다 무시하면,, ParamType, T 둘 다 char*겠지? 하면..틀리다!


우선 'const char* const ptr' 에서, char* 왼쪽의 const 의미와 오른쪽의 const 의미를 알고 있어야 한다.


왼쪽의 const는 ptr이 가리키는 character string이 const란 의미이고, 오른쪽의 const는 ptr 자체가 const라는 의미이다.

즉.. 우리가 보통 생각하는 const의 이미는 오른쪽의 const를 의미한다. ptr = "Another char"; 이렇게 하면 오류를 발생시키는 부분은 오른쪽의 const이다.


const char* ptr; 라고 하면, ptr의 타입 자체가 const char*라고 생각하는게 편하다. 즉 왼쪽의 const는 타입의 일부분인 것이다.


아무튼, 규칙에 의해서 무시되는 const는 오른쪽의 const이다. 따라서 T와 ParamType은 const char*로 추론된다.


+ Recent posts